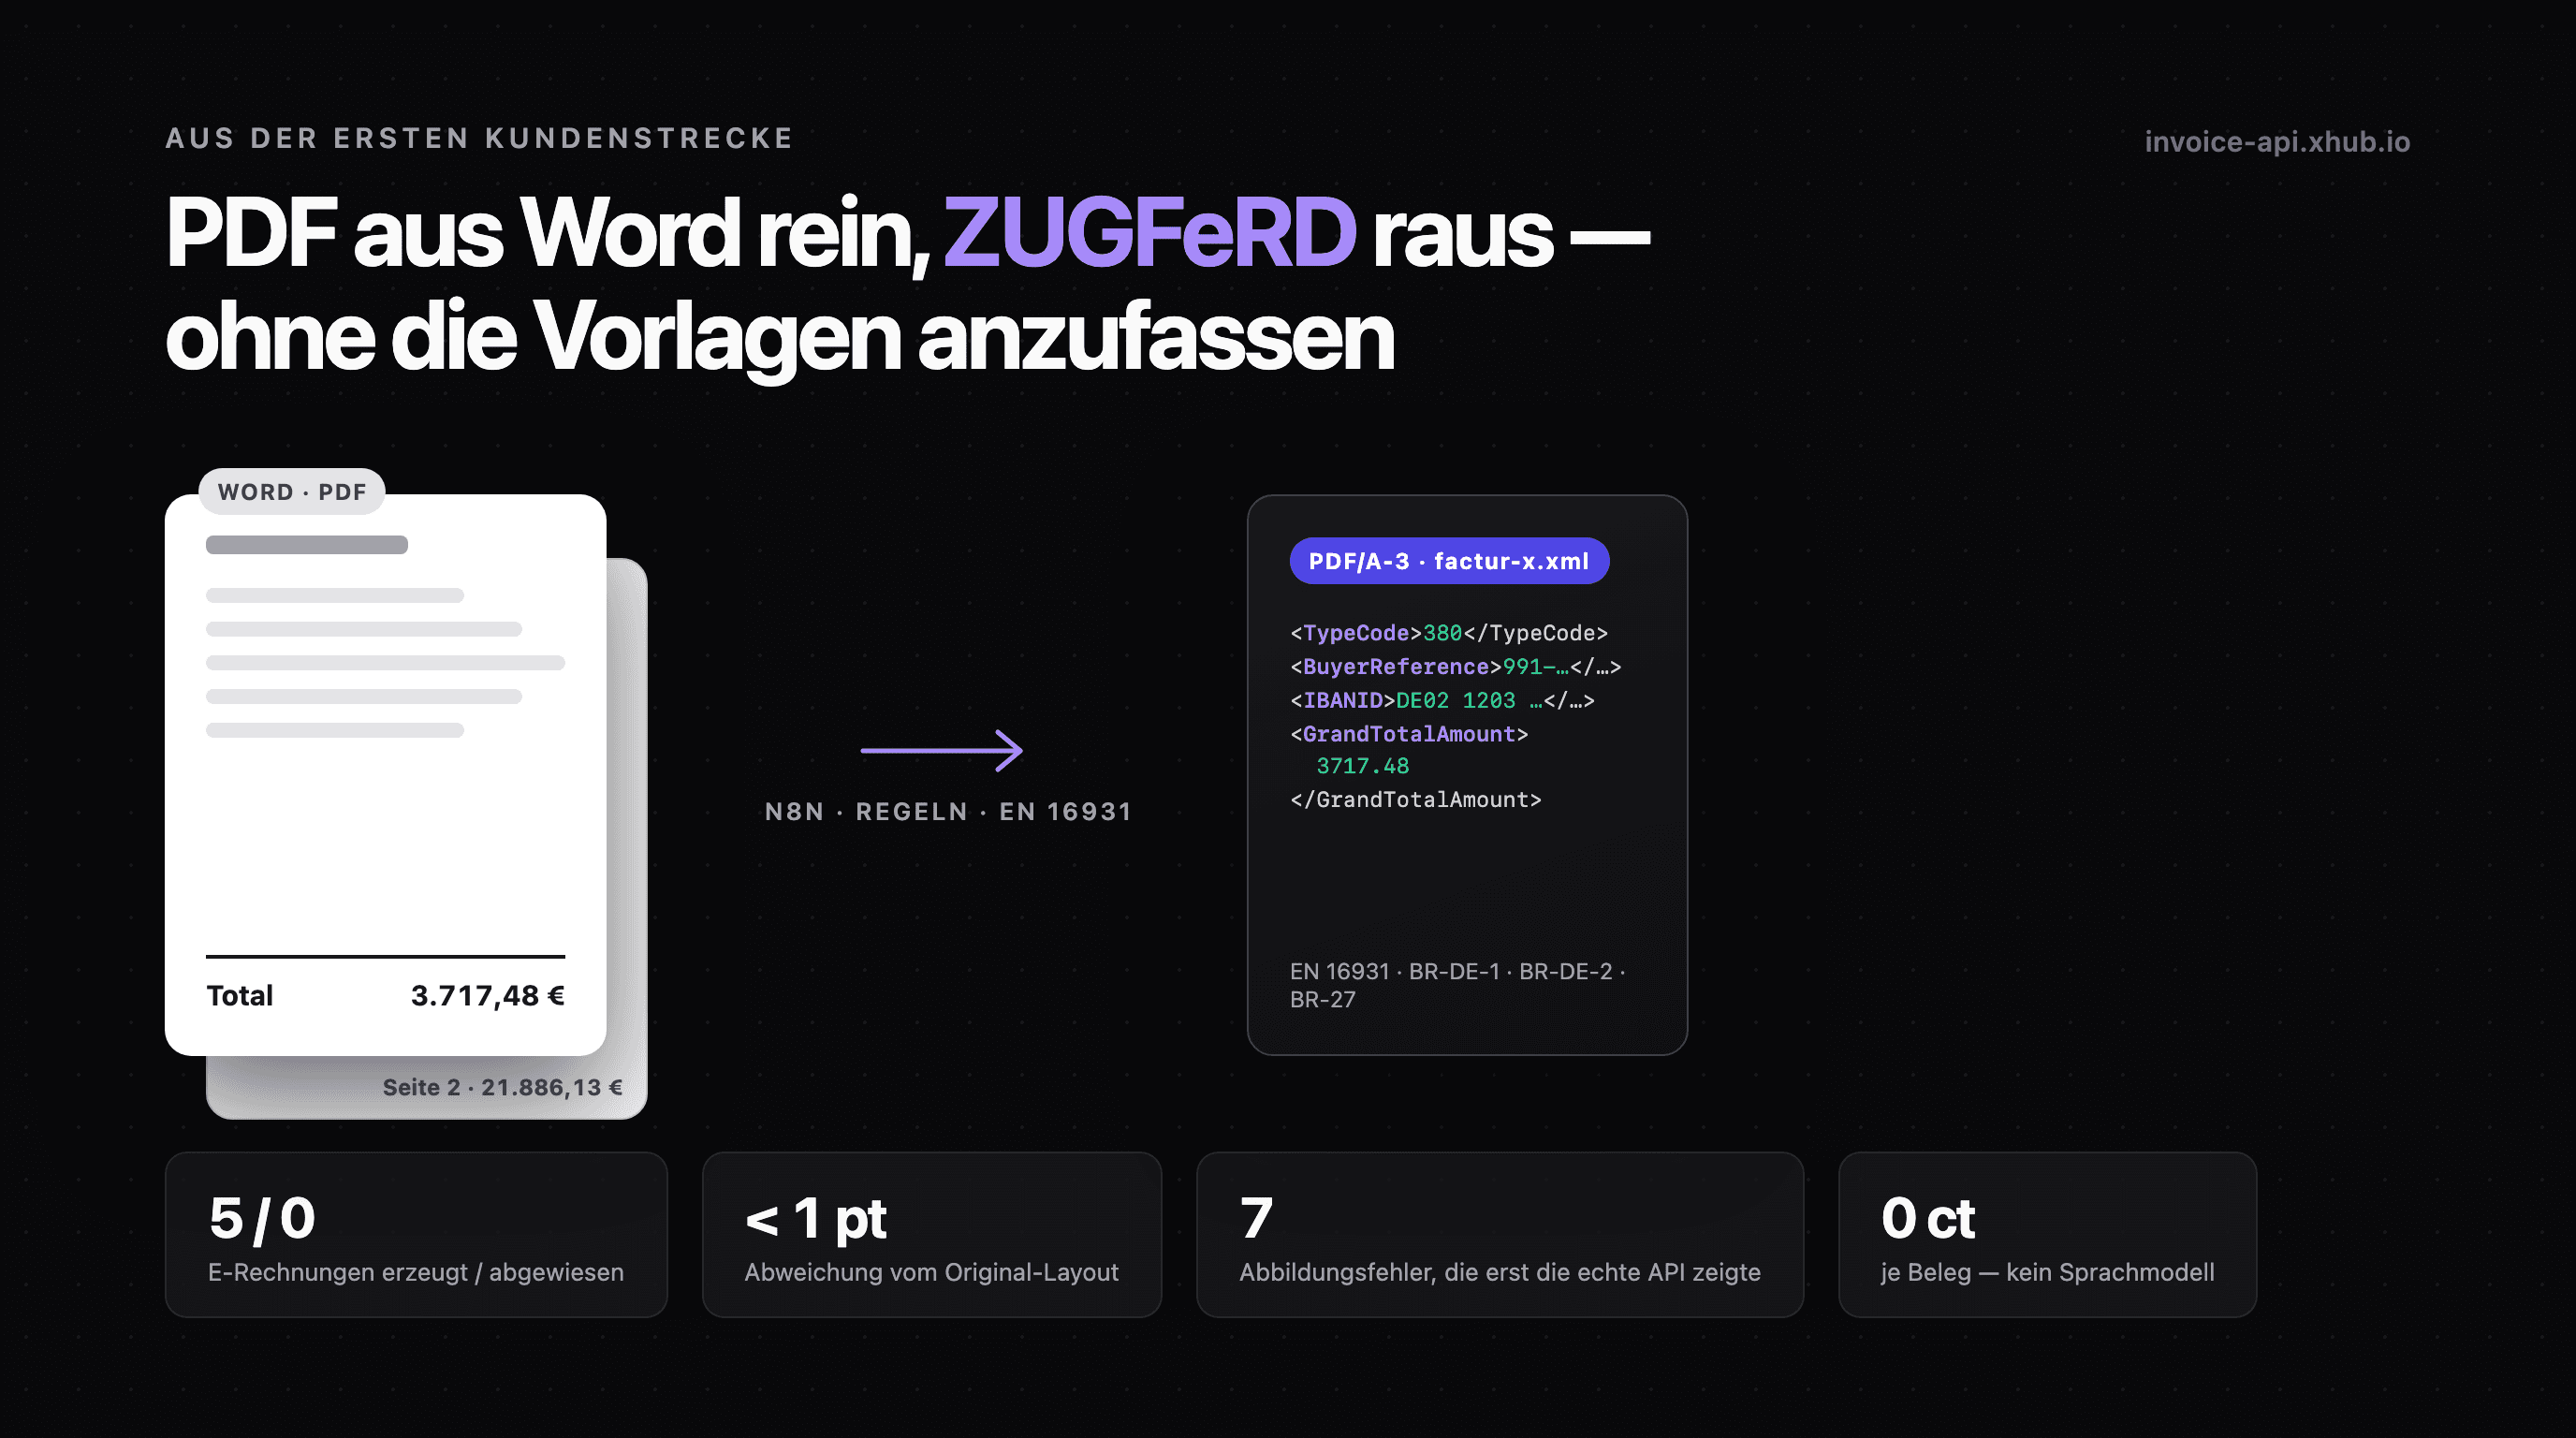
Ein PDF, zwei Rechnungen. Auf Seite 1 stand eine Rechnung über 3.717,48 €, auf Seite 2 eine über 21.886,13 €. Eine Automation, die „ein PDF = eine Rechnung" annimmt, hätte die zweite ohne Fehlermeldung verloren. Das war eine der vier Testdateien, mit denen wir unsere erste Kundenstrecke gegen die echte API gefahren haben — und der Moment, in dem klar war, dass die interessanten Probleme nicht beim Erzeugen der E-Rechnung liegen, sondern davor.
Dieser Beitrag ist der Bericht aus dieser Strecke: was wir gebaut haben, was wir wieder ausgebaut haben, welche sieben Fehler erst der echte API-Aufruf zeigte — und was ein Kunde uns über unsere eigene API beigebracht hat.
Die Ausgangslage
Der Kunde ist ein Facility-Dienstleister mit zwei Abteilungen. Beide schreiben ihre Rechnungen seit Jahren in Word und Excel, jede mit eigener Vorlage, und verschicken sie als PDF. Ab 2027 müssen sie E-Rechnungen versenden — ZUGFeRD an Firmen, XRechnung an öffentliche Auftraggeber.
Was der Kunde nicht wollte: die Vorlagen anfassen, ein neues Rechnungsprogramm einführen, die Abteilungen umschulen. Die Rechnungen existieren ja schon. Nur im falschen Format.
Also haben wir eine Strecke hinter den bestehenden Prozess gebaut. Jede Abteilung schickt ihre PDF-Rechnung wie bisher — nur nicht an den Kunden, sondern an ein eigenes Postfach. Von dort übernimmt n8n.
Die Strecke in einem Absatz
Postfach je Abteilung (IMAP) → PDF-Anhänge auftrennen → Quell-PDF archivieren → Text extrahieren → regelbasiert lesen → EN-16931-Datensatz bauen und nachrechnen → mit der invoice-api validieren → Freigabe → E-Rechnung erzeugen → ablegen → an den Käufer senden → eine Logzeile. Alles, was durchfällt, geht in einen Fehlerpfad, der eine Mail zurück an die Abteilung schickt — nie an den Käufer.
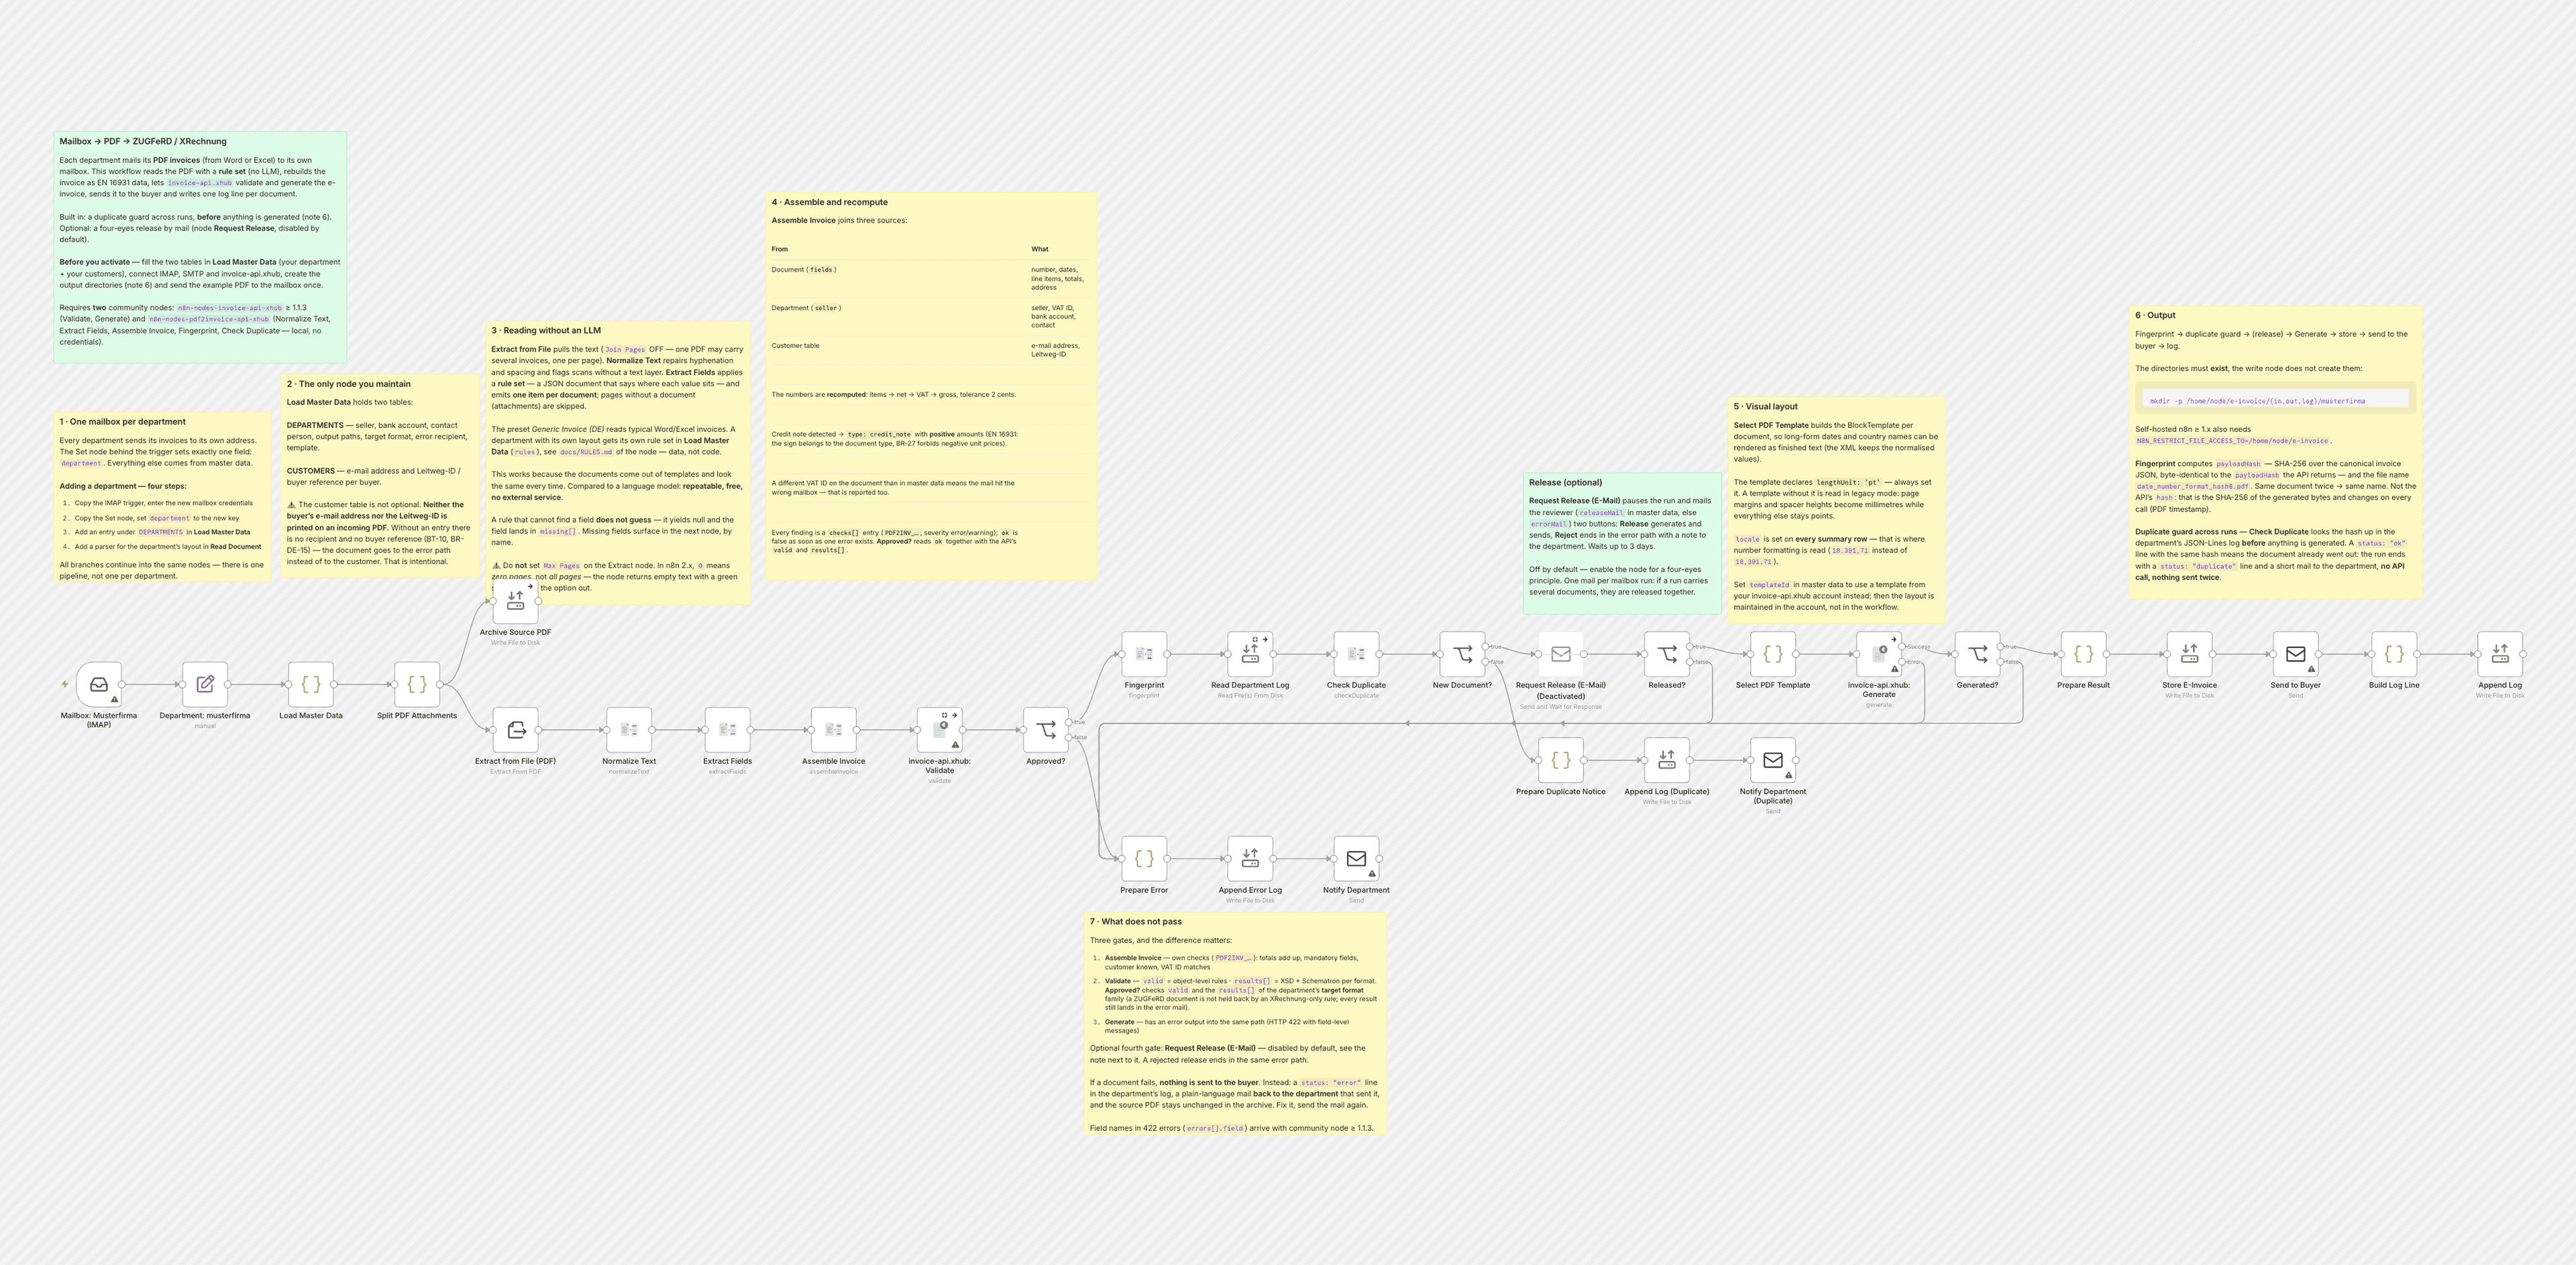
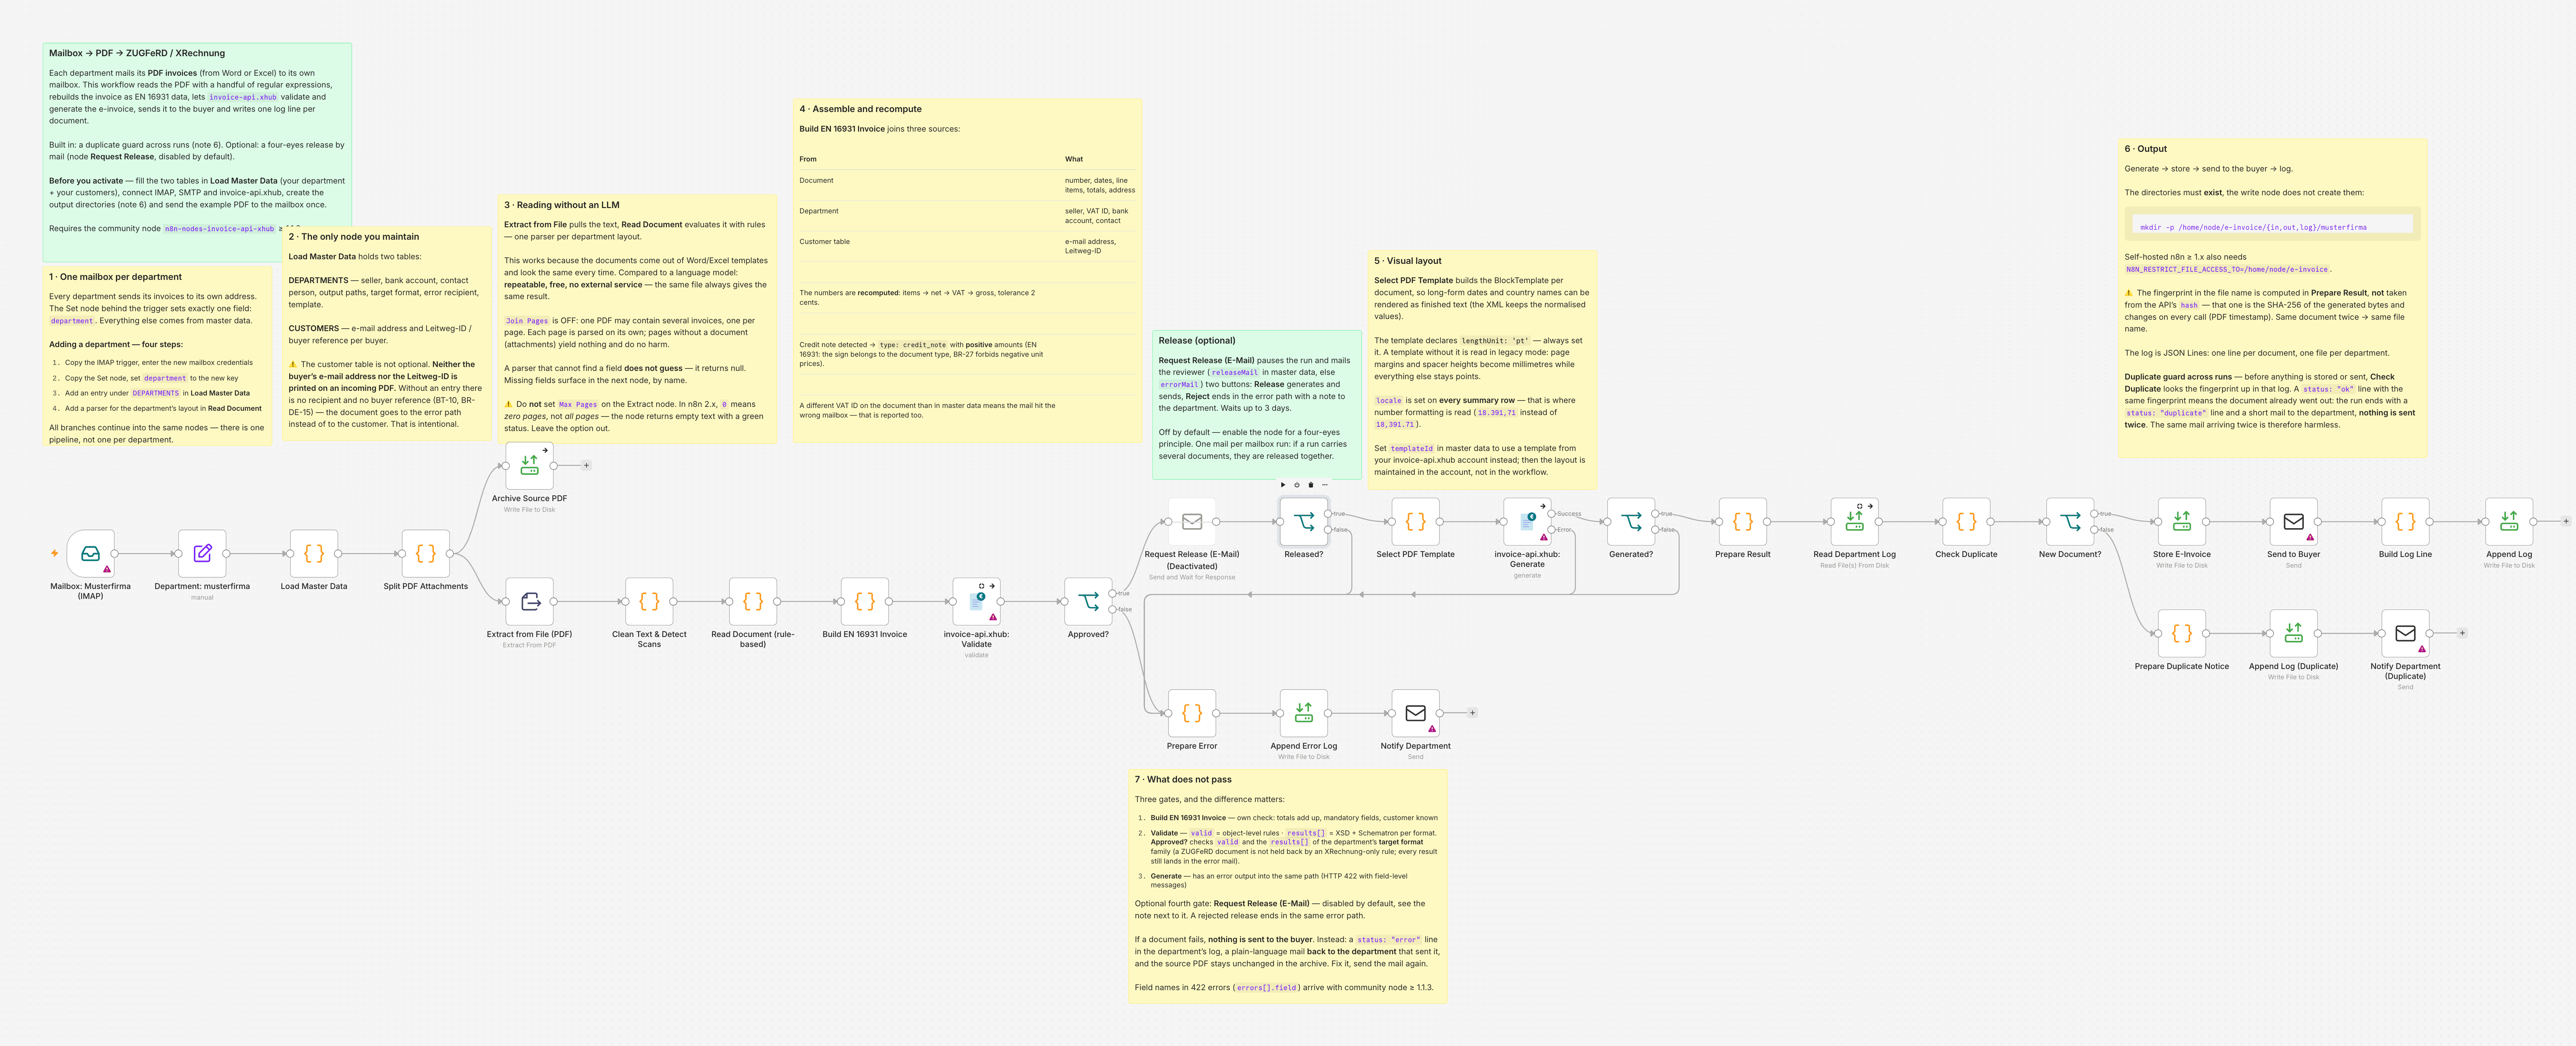
Die Strecke steht als n8n-Template zum Importieren bereit — anonymisiert, mit Musterfirma und synthetischem Testbeleg. Das Bild gibt es in voller Auflösung.
Warum ohne Sprachmodell
Version 1 der Strecke hatte ein Sprachmodell drin: PDF-Text rein, JSON raus, Temperatur 0, festes Schema. Version 2, drei Tage später, nicht mehr. Drei Gründe, und die Kosten waren der kleinste:
- Die PDFs sind gleichförmig. Sie kommen aus Word- und Excel-Vorlagen. Belegnummer, Datum, Positionen und Summen stehen jedes Mal an derselben Stelle. Reguläre Ausdrücke lesen das deterministisch — dieselbe Datei ergibt immer dasselbe Ergebnis. Ein Sprachmodell lohnt sich bei wechselnden Fremdlayouts. Bei eigenen Vorlagen ist es eine Fehlerquelle mit Rechnung.
- Kein externer Dienst, null Cent je Beleg. Die Strecke läuft ohne Internetabhängigkeit außer der invoice-api selbst.
- n8n 2.x weigert sich, einen Workflow zu aktivieren, solange irgendwo ein Knoten ohne Credentials hängt — auch auf einem Zweig, der nie läuft. Der LLM-Zweig ohne API-Key blockierte den ganzen Workflow. Raus damit.
Was blieb, ist ein Kontrakt, der sich als das Wichtigste an der ganzen Strecke herausgestellt hat: Ein Parser, der ein Feld nicht findet, liefert null. Er rät nicht. Was fehlt, fällt in der nachgelagerten Prüfung auf und wird beim Namen genannt. Ändert eine Abteilung ihre Word-Vorlage, bricht der Parser — laut, nicht leise. Der Beleg landet im Fehlerpfad, die Abteilung bekommt eine Mail.
Was auf dem PDF nicht steht
Wir haben alle vier Testbelege daraufhin geprüft: Weder die Mailadresse des Käufers noch seine Leitweg-ID stehen auf einer klassischen Rechnung. Beides musste nie dort stehen. Für eine E-Rechnung braucht man beides — die Adresse für den Versand, die Leitweg-ID als Käuferreferenz (BT-10), die Deutschland in beiden Formaten verlangt, nicht nur bei XRechnung.
Deshalb hat die Strecke eine Kundentabelle: Käufername wie gedruckt, Mailadresse, Leitweg-ID. Ohne Eintrag gibt es keinen Empfänger. Der Beleg hält an, die Abteilung bekommt eine Rückmeldung. Das ist Absicht — lieber eine Mail an die Abteilung als eine unzustellbare E-Rechnung.
Dazu kommen die Stammdaten je Abteilung: Bankverbindung (BR-DE-1 verlangt Zahlungsangaben), Ansprechpartner mit Telefon und E-Mail (BR-DE-2), USt-IdNr. Auch das steht auf dem Briefkopf, aber in keinem Datensatz.
Die Kundentabelle ist die wichtigste Tabelle der Strecke, und sie steht auf keinem Beleg. Wer eine solche Strecke plant, sollte sie als Erstes beim Kunden einfordern.
Drei Prüfstufen — und warum die Unterscheidung zählt
Bevor eine E-Rechnung rausgeht, muss sie durch drei Tore:
| Stufe | Wer prüft | Was |
|---|---|---|
| 1 | Die Strecke selbst | Positionen → Netto → USt. → Brutto mit 2 Cent Toleranz; Pflichtfelder; Käufer in der Kundentabelle; USt-IdNr. des Belegs = USt-IdNr. der Abteilung |
| 2 | /validate → valid | Objektregeln: Pflichtfelder, Summen, Formate der Kennungen |
| 3 | /validate → results[] | Je Zielformat das erzeugte XML gegen XSD und Schematron — die Regeln, an denen ein Empfänger die Rechnung tatsächlich abweist |
Der Punkt, den wir selbst erst spät verstanden haben: valid und results[] sind zwei Antworten. Eine Rechnung kann valid: true sein und trotzdem in results[0].valid: false an BR-DE-15 scheitern. Unsere erste Freigabe prüfte nur valid. Jetzt verlangt sie beides. Wer nur auf valid gatet, sieht Formatverstöße erst beim Erzeugen — oder gar nicht.
Der Abgleich der USt-IdNr. in Stufe 1 ist übrigens kein Rundungsschutz, sondern ein Postfach-Detektor: Trägt ein Beleg eine andere USt-IdNr. als die Abteilung, ging die Mail ans falsche Postfach.
Die sieben Abbildungsfehler
Das hier ist der Teil, den wir vorher nicht hätten aufschreiben können. Unser eigener Schema-Check war grün. Die API hat den Beleg trotzdem abgewiesen — siebenmal, und jedes Mal zu Recht:
| # | Was wir hatten | Was richtig ist |
|---|---|---|
| 1 | type: "creditnote" | credit_note — die gültigen Werte sind invoice, credit_note, proforma, correction |
| 2 | dueDate weggelassen, wenn der Beleg keins nennt | dueDate ist Pflicht; Ersatz ist das Belegdatum, nicht das Weglassen |
| 3 | countrySpecific: { buyerReference } | countrySpecific.countryCode: "DE" ist Pflicht — ohne es wird die Gruppe still verworfen, und mit ihr die Leitweg-ID |
| 4 | paymentMeans: { iban, bic } | Gibt es nicht. Die Bankverbindung gehört an seller.bankAccount |
| 5 | Kein Ansprechpartner | BR-DE-2: seller.contact mit Name, Telefon, E-Mail |
| 6 | Bankverbindung allein | BR-DE-1: zusätzlich paymentMethods: [{ type: "bank_transfer" }] — und paymentTerms ohne Text verstößt gegen PEPPOL-EN16931-R008 |
| 7 | Negative Einzelpreise bei der Gutschrift | BR-27 verbietet sie — das Vorzeichen trägt der Belegtyp |
Die Lehre daraus ist keine Liste, sondern eine Methode: Der Prüfstand gegen die echte API ist der Test. Nicht das Schema, nicht der Mock. Alle vier Muster-PDFs sind durch die Knoten des Workflows gelaufen und gegen die produktive API validiert und erzeugt worden — nicht simuliert. Das Ergebnis: 5 E-Rechnungen aus 4 PDFs, 0 abgewiesen, jede ein PDF/A-3 mit eingebettetem factur-x.xml.
Gutschriften: das Vorzeichen trägt der Belegtyp
Einer der vier Testbelege war eine Gutschrift über 2.130,49 € mit 7 % USt. statt 19 %. Auf dem PDF steht sie mit Minusbeträgen. Als Rechnung durchgereicht wäre daraus eine Forderung geworden — zum falschen Steuersatz.
EN 16931 löst das anders als die Optik des Belegs: Der Belegtyp ist credit_note, alle Beträge sind positiv, Menge und Einzelpreis auch. Wer die Zahlen vom PDF durchreicht, produziert einen Beleg, der strukturell sauber aussieht und an BR-27 scheitert. Die Strecke erkennt die Gutschrift am Beleg, dreht das Vorzeichen und setzt den Typ.
Und noch ein Detail aus demselben Beleg: Die Positionen in der Anlage ergaben 1.967,32 €, ausgewiesen waren 1.991,11 € — 23,79 € Unterschied. Wir haben die Anlage bewusst nicht nachgerechnet, sondern eine Sammelposition über den ausgewiesenen Betrag gebildet und die Differenz gemeldet. Woher sie kommt, klärt der Kunde. Eine Strecke, die alles durchwinkt, ist keine Automatisierung, sondern ein schnellerer Weg, Fehler zu verschicken.
Ein PDF, zwei Rechnungen
Zurück zur Testdatei vom Anfang. Zwei Rechnungen, eine je Seite. Die Lösung ist unspektakulär: den PDF-Text seitenweise lesen (in n8n: Join Pages aus), jede Seite einzeln durch den Parser schicken. Seiten ohne Beleg — Anlagen, AGB — liefern nichts und stören nicht.
Die Gegenrichtung ist genauso wichtig: Zwei der vier Testdateien enthielten denselben Beleg. Beide ergeben denselben Dateinamen und überschreiben sich harmlos, statt eine Dublette zu erzeugen. Das funktioniert über einen Fingerabdruck über die Rechnungsdaten mit stabiler Schlüsselreihenfolge — und ausdrücklich nicht über den Hash, den die API mit dem Dokument zurückgibt.
Warum nicht? Weil dieser Hash der Hash der Ausgabe-Bytes ist. Ein PDF trägt einen Erzeugungszeitpunkt, also ändert sich der Wert bei jedem Aufruf, auch bei identischer Eingabe. Als Dubletten-Kennung taugt er nicht. Das stand nirgends — was uns zum letzten Abschnitt bringt.
Was die Strecke uns über unsere eigene API beigebracht hat
Der erste Kunde ist der beste Test, den man nicht selbst schreiben konnte. Drei Dinge, die wir gefunden haben, standen in keiner Dokumentation — auch nicht in unserer:
- Der
hashin der Antwort ist ein Byte-Hash des Dokuments, für PDF also nicht aufrufstabil. Jetzt steht das in der API-Beschreibung, und die Antwort enthält zusätzlich einenpayloadHashüber die Eingabedaten — der ist es, den man für Idempotenz braucht. - Unsere Vorlagen-Doku sagte „in points", der Renderer las Seitenränder und Abstandshöhen ohne das Feld
lengthUnitaber als Millimeter — ein historisch gewachsener Vertrag, der intern dokumentiert war und extern nicht. Jetzt stehtlengthUnitin der OpenAPI, samt Regel für alte Vorlagen. - Unser n8n-Community-Node zeigte bei HTTP 422 nur „Request failed with status code 422" — der Feldname aus der API-Antwort (
seller.bankAccount.bankName) ging verloren. Seit Version 1.1.3 kommt er durch, und der Fehlerpfad eines Workflows bekommterrors[]maschinenlesbar.
Alles drei ist behoben. Und alles drei wäre ohne einen Kunden, der die API in einer echten Strecke benutzt, noch da.
Was die Strecke nicht kann
Ehrlichkeit gehört dazu:
- Gescannte PDFs ohne Textebene gehen in den Fehlerpfad. Keine OCR eingebaut.
- Ändert eine Abteilung ihre Word-Vorlage, bricht ihr Parser. Auffällig, nicht still — aber jemand muss ihn nachziehen.
- Kein Dublettenschutz über Läufe hinweg. Zweimal dieselbe Mail heißt zweimal dieselbe E-Rechnung an den Käufer. Die Ablage überschreibt sich sauber, der Versand nicht.
- Keine Freigabe durch einen Menschen. Was durch die drei Prüfstufen geht, geht raus. Ein Wait-Knoten mit Freigabe-Mail wäre einzuschieben.
Nachbauen
Die Strecke steht als n8n-Template bereit: Musterfirma, generischer Parser, alle drei Prüfstufen, Fehlerpfad, Fingerabdruck. Import, Stammdaten eintragen, Postfach verbinden, einen Beleg durchschicken.
Die sieben Abbildungsfehler mit Regel-IDs und Korrekturen stehen ausführlich im Wissen-Guide PDF-Rechnung zur E-Rechnung.
Und wenn die Vorlagen bei euch anders aussehen als bei uns — sie tun es immer — schreibt uns. Eine Abteilung anzubinden ist ein Nachmittag Arbeit, wenn man die Fallen kennt.