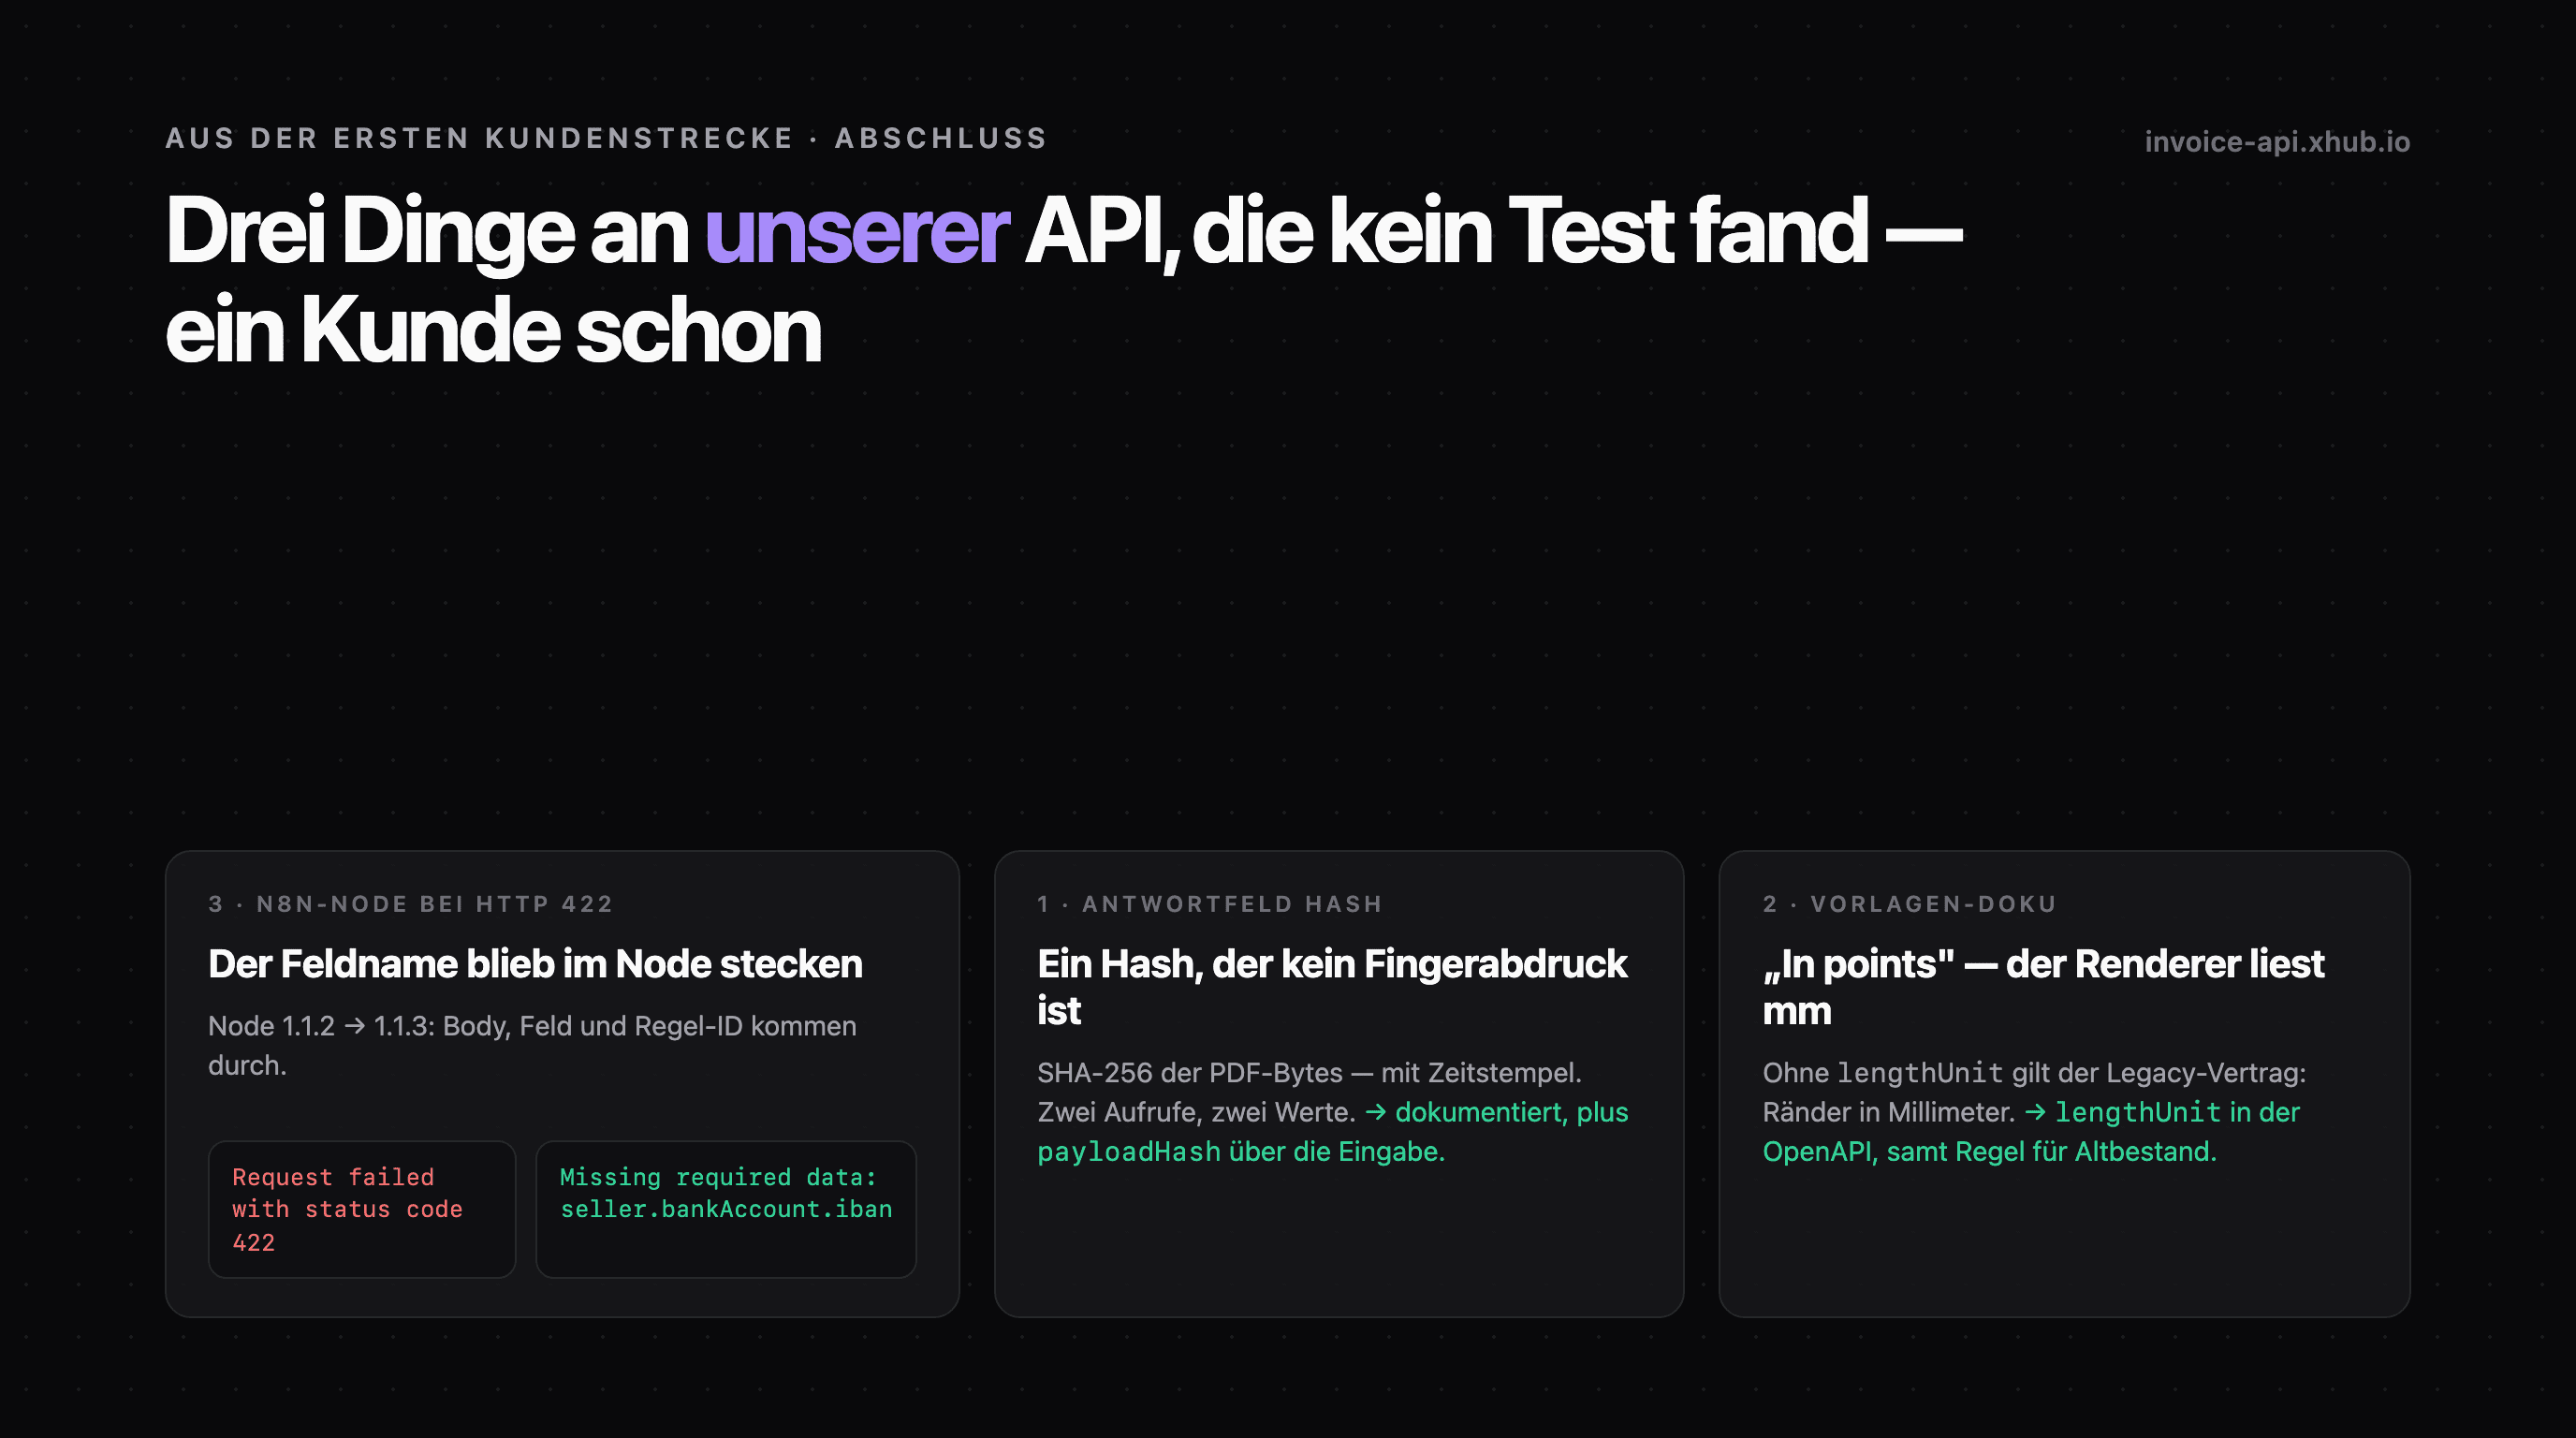
Drei Dinge an unserer eigenen API haben wir erst gefunden, als wir sie für einen Kunden eingesetzt haben. Alle drei standen in keiner Doku. Auch nicht in unserer. Dieser Beitrag ist der Abschluss der Serie über unsere erste Kundenstrecke — und der Teil, der uns selbst am meisten gebracht hat.
Die Strecke: ein Facility-Dienstleister mit zwei Abteilungen, Rechnungen aus Word und Excel, ab 2027 E-Rechnungspflicht. Wir haben mit n8n und unserer API eine Strecke dahinter gebaut, die PDFs aus dem Postfach liest, als EN 16931 nachbaut und als ZUGFeRD versendet. Sie funktioniert. Aber unterwegs hat sie drei Stellen gefunden, an denen unsere Doku etwas anderes behauptete als unser Code.
1. Der Hash in der Antwort ist kein Fingerabdruck
Die Antwort auf „E-Rechnung erzeugen" enthält ein Feld hash. Wir wollten es in der Strecke als Teil des Dateinamens verwenden: Derselbe Beleg, zweimal empfangen, soll denselben Dateinamen bekommen — dann überschreibt sich die Ablage harmlos, statt eine Dublette anzulegen. Die Testdaten enthielten genau diesen Fall: zwei Dateien, ein Beleg.
Es ging nicht. Zwei Aufrufe mit identischer Eingabe lieferten zwei verschiedene Hashes. Der Grund steht im Code, nicht in der Doku: hash ist die SHA-256-Prüfsumme der erzeugten Bytes. Bei einer PDF/A-3 enthalten die einen Erstellungszeitstempel und eine Dokument-ID — jeder Aufruf erzeugt andere Bytes, also einen anderen Hash. Als Integritätsnachweis für die Datei ist das korrekt. Als Fingerabdruck des Belegs ist es unbrauchbar.
Die Strecke rechnet deshalb ihren eigenen Fingerabdruck über die Rechnungsdaten (FNV-1a über das kanonisch sortierte JSON). Und wir haben zwei Dinge geändert:
- Die Beschreibung von
hashin der OpenAPI sagt jetzt, was es ist: Hex-SHA-256 der zurückgegebenen Dokument-Bytes, leer bei 422, für PDF-Ausgaben nicht aufrufstabil. - Es gibt zusätzlich
payloadHash: SHA-256 über die kanonisch sortierte Eingabe. Gleiche Daten in anderer Feldreihenfolge ergeben denselben Wert. Das ist der Fingerabdruck, den die Strecke sich selbst gebaut hatte — jetzt liefert ihn die API.
Was wir daraus gelernt haben: Ein Feld, das hash heißt, verspricht mehr, als eine Zeile Beschreibung einlösen muss. Wenn zwei Dinge gehasht werden könnten, muss die Doku sagen, welches.
2. „In points" — aber der Renderer liest Millimeter
Die Sichtvorlage der E-Rechnung (das PDF, das der Käufer sieht) wird aus einer Blockvorlage gerendert. Die OpenAPI beschrieb page.margins mit „Top margin in points". Die Strecke setzte die Ränder in Punkt, vermaß das Ergebnis mit pdftotext -bbox gegen das Original — und lag um den Faktor 2,83 daneben.
Der Renderer hat einen historisch gewachsenen Vertrag: Eine Vorlage ohne das Feld lengthUnit gilt als Altdatei, und für Altdateien sind Seitenränder und Spacer-Höhen Millimeter, alles andere Punkt. Das war im Renderer dokumentiert, im Editor gefixt — und in der REST-OpenAPI schlicht nicht vorhanden. Die OpenAPI ist ein handgepflegtes Duplikat des Renderer-Schemas, und das Feld lengthUnit hatte den Weg dorthin nie gefunden.
Die Strecke hat die mm-Werte gemessen und eingetragen. Das war die falsche Reaktion — die richtige wäre gewesen, die Doku zu korrigieren. Inzwischen ist beides passiert:
lengthUnit(pt|mm|inch) steht in der OpenAPI, mit der Legacy-Regel im Beschreibungstext.- Die Beschreibungen von Rändern, Spacer-Höhen und Sektionshöhen sagen „in lengthUnit; mm, wenn lengthUnit fehlt".
- Das öffentliche n8n-Template setzt
lengthUnit: 'pt'— immer.
Was wir daraus gelernt haben: Eine Doku, die aus einer zweiten Quelle abgeschrieben ist, driftet. Wer ein Schema zweimal pflegt, pflegt eines davon nicht.
3. Der n8n-Node verschluckt den Feldnamen
Die API antwortet bei einem unvollständigen Beleg mit HTTP 422 und einem Body, der den Fehler benennt: errors[].message = „Missing required data: seller.bankAccount.iban", bei Schematron-Verstößen zusätzlich complianceErrors[] mit Regel-ID. Unser eigener n8n-Community-Node zeigte davon nichts. Im Workflow stand: „Request failed with status code 422". Den Feldnamen musste man sich aus dem Kontext denken.
Der Grund: Der Node parste den Antwort-Body nur bei HTTP 200 mit success: false. Bei 4xx warf er den rohen HTTP-Fehler weiter, und n8n ersetzt dessen Message durch einen generischen Text. Die Betriebsanleitung der Strecke bekam deshalb einen Absatz „Fehlerdetails sind im Node nicht sichtbar" — eine Betriebsanleitung, die ein Produktproblem erklärt, statt dass das Produkt es löst.
Seit Version 1.1.3 des Nodes kommt der Body durch: Message mit Feldname, errors[], complianceErrors[] und httpCode auch am Fehlerausgang des Nodes, so dass ein Workflow sie in der Rückmeldung an die Abteilung verwenden kann. Beim Bauen des Fixes ist noch etwas aufgefallen: new NodeApiError(node, err, { message }) verwirft die neue Message stillschweigend, wenn err bereits ein NodeApiError ist. Der erste Testlauf war rot, weil die Doku von n8n das auch nicht sagt.
Was wir daraus gelernt haben: Alles, was der erste Kunde findet, gehört ins Produkt — nicht in seine Betriebsanleitung. Ein Absatz „bekannte Einschränkung" ist eine Rechnung, die jeder nächste Kunde noch einmal bezahlt.
Warum kein Test das gefunden hat
Keins der drei war ein Bug im engen Sinn. Der Hash war korrekt, der Renderer war korrekt, der Node lieferte einen Fehler. Alle drei waren Stellen, an denen die Doku etwas anderes behauptete als der Code — und an denen unsere eigenen Tests nichts merken konnten, weil sie dasselbe annahmen wie die Doku. Ein Test, der aus der Dokumentation abgeleitet ist, prüft die Dokumentation gegen sich selbst.
Der erste Kunde ist der beste Test, den man nicht schreiben konnte. Er kommt ohne unsere Annahmen, liest die Doku wörtlich und baut darauf. Was dabei bricht, ist die Doku, nicht der Kunde.
Was sich seitdem geändert hat
- OpenAPI:
hashehrlich beschrieben,payloadHashneu,lengthUnitmit Legacy-Regel,validals Objekt-Urteil mit Verweis aufresults[].valid. - Renderer:
localeauf Blockebene eines Summary-Blocks wird an die Zeilen vererbt (das war ein echter Bug, der vierte Fund, der hier keinen eigenen Abschnitt bekommt),headerRows/footerRowsoptional. - n8n-Node 1.1.3: 422/400-Bodys durchgereicht, OpenAPI-Sync-Script vor jedem Release,
LICENSE-Datei, die das README schon immer verlinkt hatte. - Template 06: PDF-Rechnungen aus dem Postfach → ZUGFeRD / XRechnung mit
lengthUnit, Gate aufvalid && results[]und eigenem Fingerabdruck. - Wissen: PDF-Rechnung zur E-Rechnung — die sieben Abbildungsfehler, die nur ein echter API-Aufruf zeigt.
Wenn Sie eine ähnliche Strecke bauen und an einer Stelle hängen, an der die Doku etwas anderes sagt als der Code: Schreiben Sie uns. Wir wollen das wissen — es ist der Test, den wir nicht schreiben können.